Kenapa Membuat Video dengan Kode?
Saat model seperti Veo dan berbagai video generation model lain sudah bisa menghasilkan video hanya dari prompt, aku justru memilih pendekatan yang kelihatannya lebih ribet:
membuat video menggunakan kode.
Alasannya bukan karena pendekatan ini lebih mudah.
Justru sebaliknya.
Tapi untuk use case Lana, aku membutuhkan tiga hal yang menurutku lebih sulit dijaga dengan native video generation: cost, consistency, dan control.
Lana dibuat untuk menghasilkan video explanation dengan visual bergaya whiteboard dan crayon yang fun. Tujuannya bukan menghasilkan video cinematic atau realistis, tetapi membuat sebuah konsep menjadi lebih mudah dipahami.
Kalau bentuk visual yang dibutuhkan relatif terstruktur, menurutku tidak masuk akal kalau setiap frame harus dihasilkan menggunakan video generation model yang mahal.
Jadi aku mulai mengeksplorasi pertanyaan yang berbeda:
bagaimana kalau AI tidak menghasilkan videonya secara langsung, tetapi menghasilkan instruksi yang kemudian dirender menjadi video menggunakan kode?
Berawal dari Ngerti.in
Ide Lana sebenarnya muncul ketika aku mengembangkan Ngerti.in.
Dari feedback beberapa user, aku menemukan bahwa mereka lebih mudah memahami sebuah materi ketika penjelasannya disampaikan melalui video dibandingkan hanya membaca teks.
Aku awalnya bisa saja menambahkan fitur "generate video" langsung ke Ngerti.in.
Tapi menurutku problem ini cukup menarik untuk berdiri sendiri.
Membuat explanation video ternyata bukan cuma persoalan mengubah teks menjadi video.
Ada banyak pertanyaan di dalamnya:
- Bagaimana sebuah konsep diterjemahkan menjadi visual?
- Kapan teks perlu muncul?
- Kapan diagram lebih efektif?
- Bagaimana visual mengikuti narasi?
- Bagaimana menjaga style setiap scene tetap konsisten?
- Dan bagaimana semuanya bisa dibuat secara otomatis?
Pertanyaan-pertanyaan itu yang akhirnya menjadi fondasi Lana.
LLM sebagai Director, Bukan Renderer
Aku tidak menghilangkan LLM dari pipeline Lana.
Justru LLM tetap memegang peran penting.
Yang aku hindari adalah menggunakan generative video model sebagai renderer utama.
Secara sederhana, aku melihat arsitektur Lana seperti ini:
Learning Material
      ↓
     LLM
      ↓
Understand & Plan Explanation
      ↓
Scene / Visual Instructions
      ↓
Code Generation
      ↓
Remotion / React / Manim
      ↓
Voice + Timing
      ↓
Final Video
LLM bertugas memahami materi dan membantu merencanakan bagaimana konsep tersebut sebaiknya dijelaskan.
Tetapi visual akhirnya dibangun secara deterministic melalui kode.
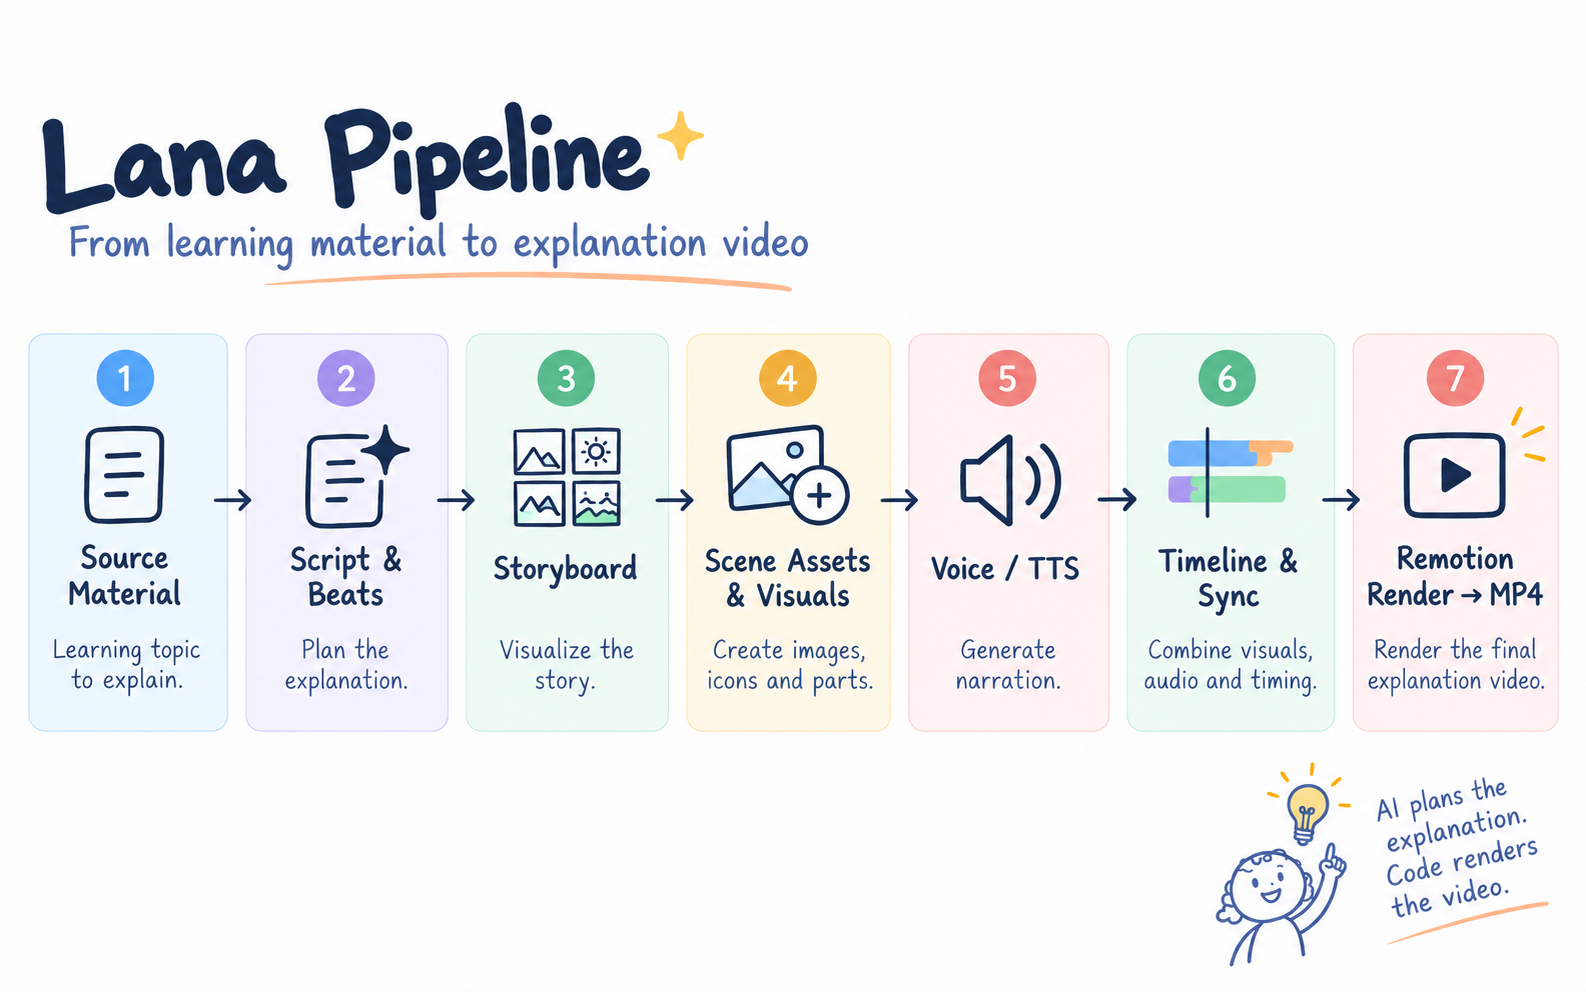
Pendekatan ini memberiku kontrol yang jauh lebih besar.
Kalau sebuah scene membutuhkan diagram, aku bisa membuat diagram.
Kalau membutuhkan tulisan tangan bergaya crayon, sistem bisa menggunakan komponen yang memang dirancang untuk itu.
Kalau membutuhkan animasi objek dari titik A ke B, movement tersebut bisa ditentukan dengan jelas.
Bukan berharap model video memahami maksud prompt dengan cara yang sama setiap kali generation dilakukan.
Why Remotion and Manim?
Untuk rendering utama, Lana menggunakan Remotion.
Aku memilih Remotion karena video dapat dibangun menggunakan React. Artinya aku bisa memperlakukan scene hampir seperti membangun UI:
<ExplanationScene>
  <Title />
  <Diagram />
  <Arrow />
  <Annotation />
</ExplanationScene>
Bedanya, semuanya hidup di dalam timeline.
Pendekatan berbasis component ini cocok dengan Lana karena banyak elemen visual dapat digunakan kembali di banyak video.
Misalnya:
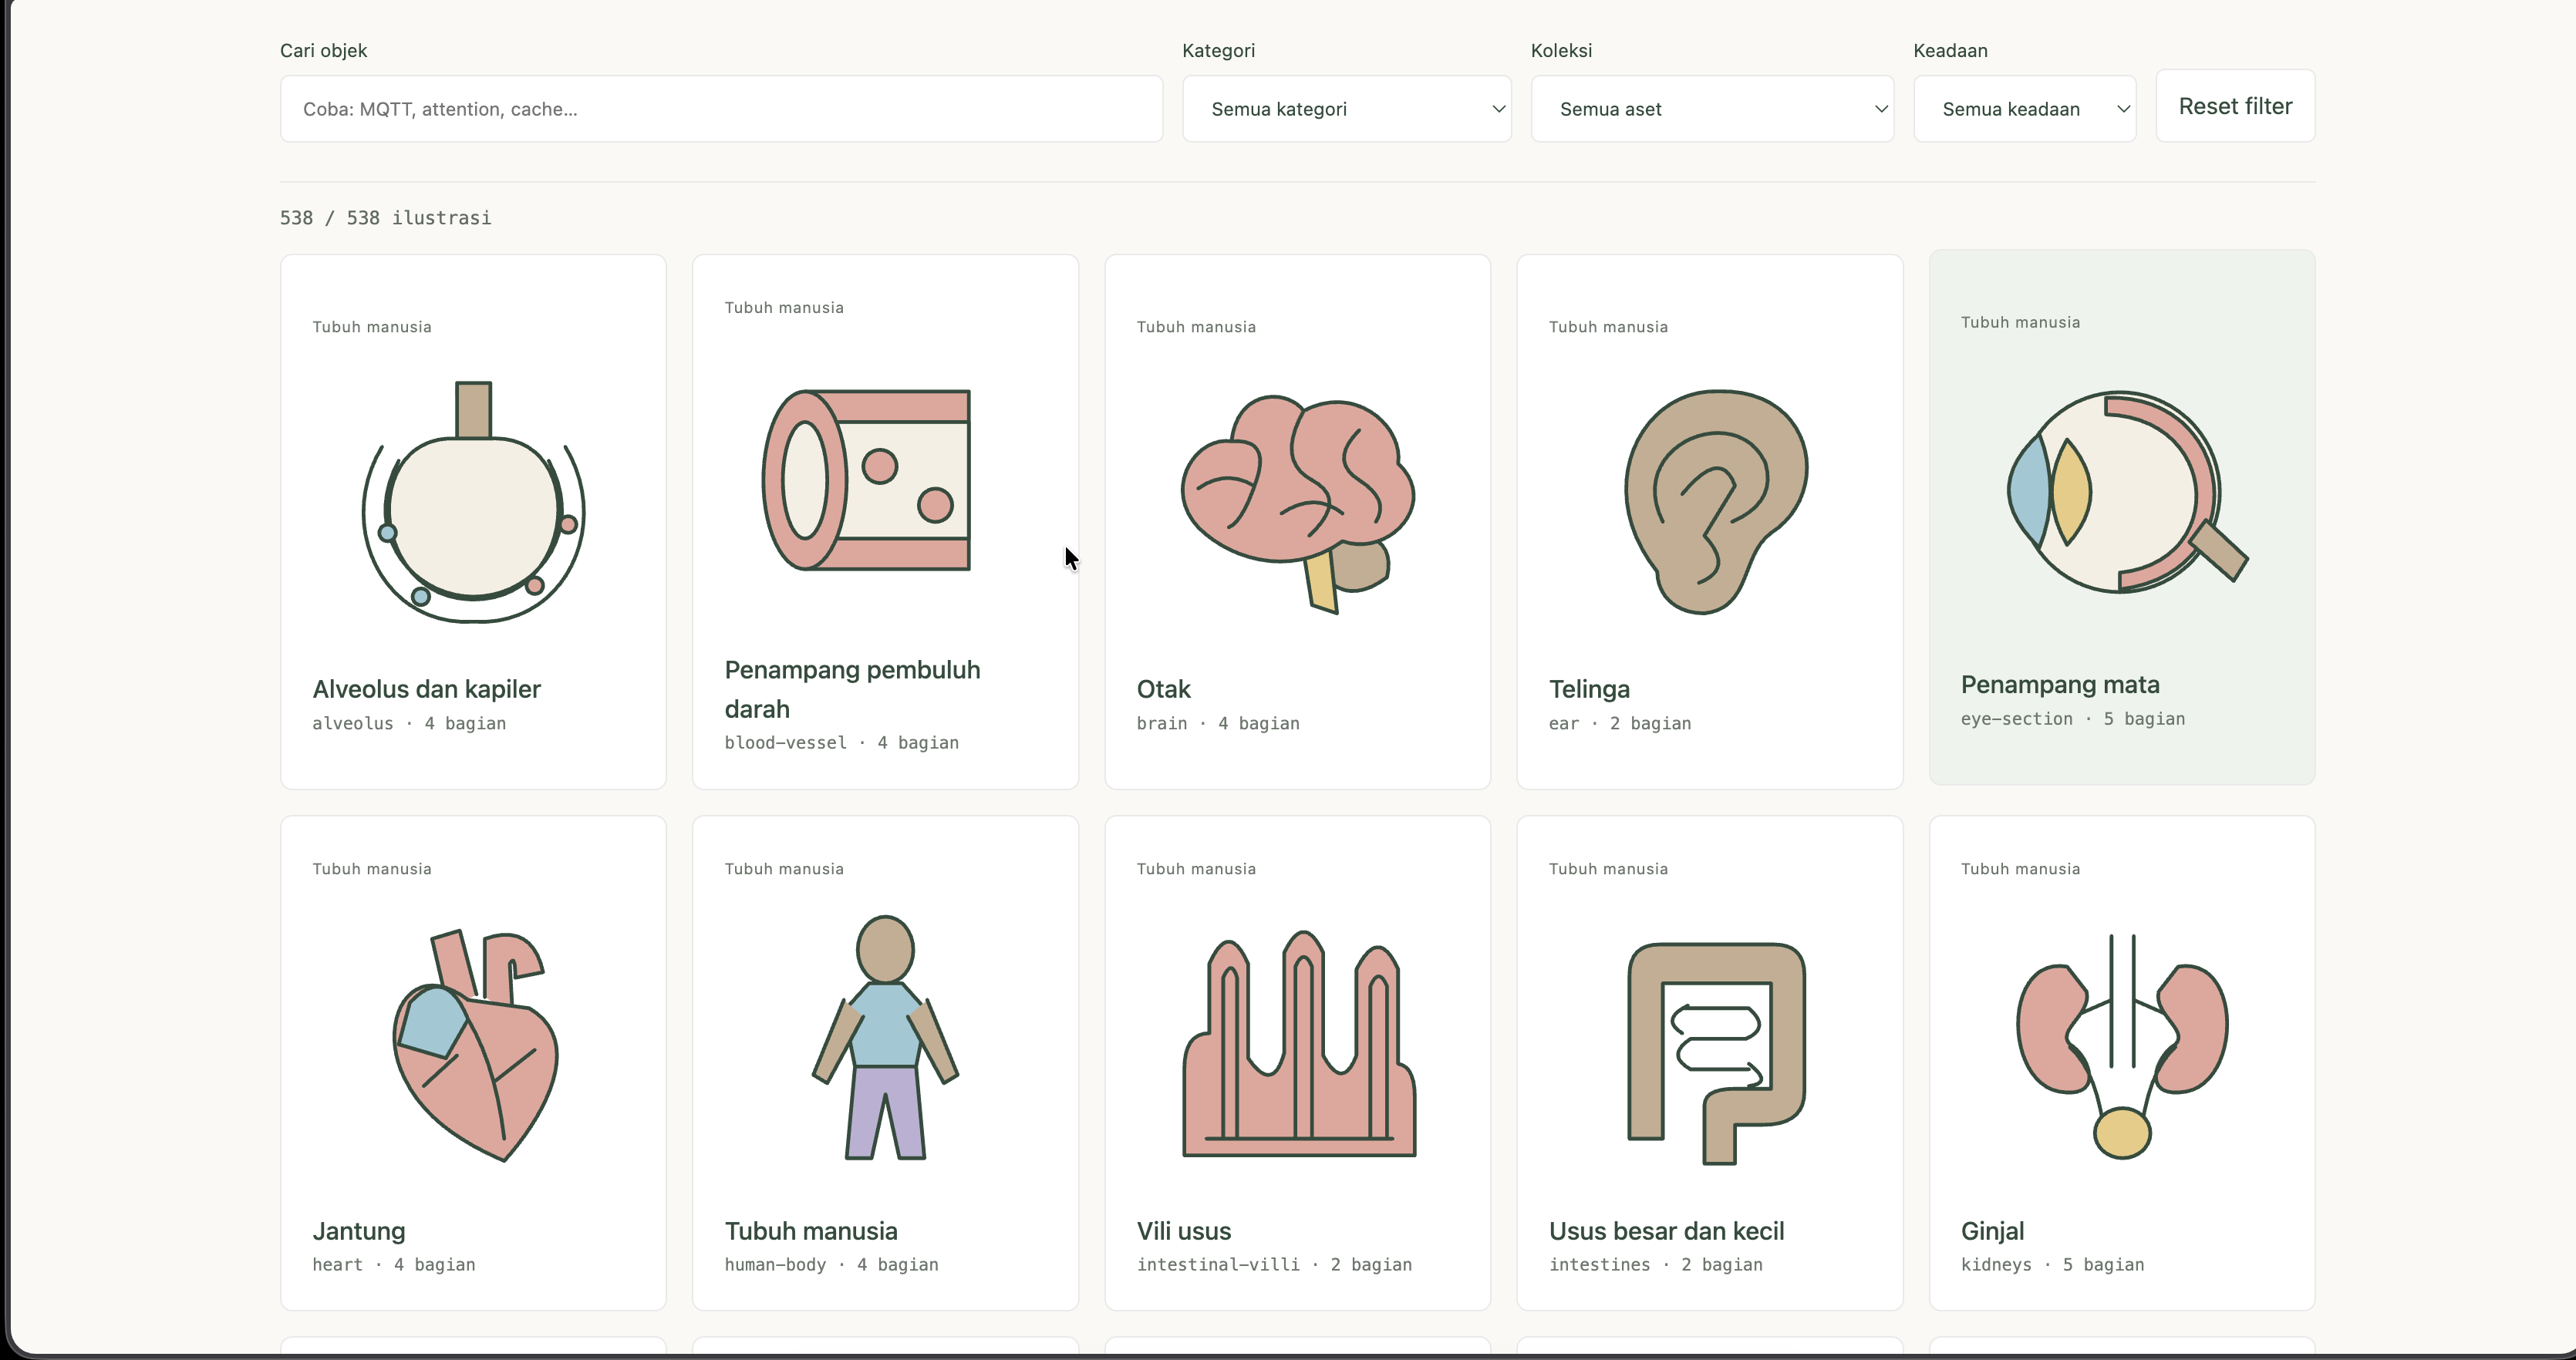
Visual Components
├── Handwritten Text
├── Arrow
├── Highlight
├── Diagram
├── Graph
├── Formula
└── Illustration
Semakin banyak primitive yang dimiliki Lana, semakin besar vocabulary visual yang bisa digunakan untuk menjelaskan sebuah materi.
Untuk visual yang lebih matematis atau membutuhkan animasi yang lebih kompleks, aku juga mengeksplorasi Manim.
Jadi bukan membuat setiap video dari nol, tetapi perlahan membangun sebuah visual system yang bisa digunakan AI untuk menyusun explanation.
Kenapa Tidak Langsung Pakai Video Generation?
Pertimbangan terbesarku adalah cost.
Native video generation membutuhkan computation yang jauh lebih besar.
Sedangkan pada Lana, sebagian besar visual sebenarnya terdiri dari bentuk sederhana: text, line, diagram, graph, illustration, movement, dan transition.
Semua itu relatif murah untuk dirender menggunakan kode.
Selain cost, ada masalah lain yang bahkan lebih penting untuk video edukasi:
consistency.
Dalam explanation video, sebuah object yang muncul di detik ke-10 seharusnya masih menjadi object yang sama ketika muncul lagi di detik ke-30.
Tulisan harus terbaca.
Diagram harus benar.
Angka tidak boleh tiba-tiba berubah.
Dan visual tidak boleh sekadar terlihat bagus tetapi malah menjelaskan konsep yang salah.
Dengan code-based rendering, aku punya lebih banyak kontrol terhadap hal-hal tersebut.
Native Video Generation
Prompt → Model → Pixels

Lana
Material → Plan → Structured Scene → Code → Pixels
Aku menukar kebebasan visual yang sangat besar dengan kontrol dan determinisme yang lebih tinggi.
Dan untuk educational explanation, menurutku trade-off itu masuk akal.
Voice dan Visual Harus Bergerak Bersama
Video explanation bukan hanya kumpulan scene.
Narasi dan visual harus terasa seperti satu pengalaman.
Untuk voice generation, Lana menggunakan Fish Audio.
Voice tersebut kemudian menjadi bagian dari timeline video, sehingga visual bisa disinkronkan dengan apa yang sedang dijelaskan.
Kalau narrator sedang menjelaskan bagian tertentu dari diagram, elemen tersebut bisa muncul atau di-highlight pada waktu yang sesuai.
Bagian ini penting karena tujuan Lana bukan hanya membuat video otomatis.
Aku ingin hasilnya terasa seperti seseorang memang merancang penjelasan tersebut.
Dari Material Menjadi Video
Saat ini pipeline Lana secara umum terdiri dari beberapa tahap.
Input Material
      ↓
Analyze Material
      ↓
Build Explanation
      ↓
Plan Scenes
      ↓
Generate Visual Instructions
      ↓
Render Components
      ↓
Generate Voice
      ↓
Synchronize
      ↓
Render Final Video
Untuk mengelola workflow yang memiliki banyak langkah tersebut, aku menggunakan LangGraph.
Pendekatan graph membuat setiap tahap memiliki responsibility yang lebih jelas, dan pipeline lebih mudah dikembangkan ketika nantinya ada step baru seperti validation, regeneration, atau visual quality checking.
State dari generation juga bisa disimpan ke PostgreSQL sehingga proses tidak harus diperlakukan sebagai satu request panjang.
Seberapa Cepat?
Saat ini Lana sudah dapat menghasilkan video explanation sekitar satu menit dalam waktu dua sampai tiga menit.
Buatku ini menjadi salah satu keuntungan menarik dari pendekatan code-based generation.
Karena tidak perlu melakukan generative inference untuk setiap frame, sebagian besar proses akhirnya adalah planning, generation asset, voice synthesis, dan rendering.
Tentu angka tersebut masih sangat bergantung pada kompleksitas video dan pipeline yang digunakan.
Tapi ini menunjukkan bahwa pendekatan programmable video cukup menarik jika use case-nya memang memiliki visual language yang terstruktur.
Masalah yang Belum Selesai
Lana masih merupakan project yang aktif aku kembangkan.
Problem terbesar yang sedang aku hadapi sekarang adalah generation consistency.
Walaupun rendering menggunakan kode bersifat deterministic, keputusan sebelum proses rendering masih dibuat oleh AI.
AI tetap harus memutuskan:
- scene apa yang perlu dibuat,
- visual apa yang cocok untuk suatu konsep,
- bagaimana layout disusun,
- seberapa banyak informasi yang muncul,
- dan bagaimana perpindahan antar scene dilakukan.
Artinya, masalah konsistensi bergeser.
Bukan lagi:
"Apakah renderer menghasilkan gambar yang sama?"
Tetapi:
"Apakah AI membuat keputusan visual yang sama bagusnya pada berbagai jenis materi?"
Itu jauh lebih menarik buatku.
Karena solusi untuk problem tersebut tidak selalu berupa model yang lebih besar.
Bisa jadi jawabannya adalah constraint yang lebih baik, visual primitives yang lebih kaya, planner yang lebih terstruktur, atau validation layer sebelum sebuah scene dirender.
Yang Aku Pelajari dari Lana
Lana membuatku melihat generative AI dari perspektif yang sedikit berbeda.
Ketika ada model yang bisa menghasilkan sesuatu secara end-to-end, sangat mudah untuk langsung menggunakan model tersebut untuk seluruh pipeline.
Tetapi menurutku pertanyaan yang lebih berguna adalah:
bagian mana yang benar-benar membutuhkan generative AI?
Untuk Lana, LLM sangat berguna dalam memahami materi dan merencanakan penjelasan.
Tapi untuk menggambar garis, memindahkan object, menampilkan teks, atau membuat diagram, kode sering kali jauh lebih murah, cepat, dan predictable.
Karena itu aku mencoba membagi responsibility dengan jelas:
AI
→ reasoning
→ planning
→ deciding what to show

Code
→ layout
→ animation
→ rendering
→ deterministic execution
Lana masih jauh dari selesai.
Tapi justru proses iterasinya yang paling menarik buatku: mencari titik di mana AI memberikan kreativitas dan reasoning, sementara kode memberikan kontrol dan konsistensi.
Dan kalau keduanya bisa bekerja dengan baik, mungkin kita tidak selalu membutuhkan model video yang sangat besar untuk membuat video explanation yang bagus.
Technologies
Hono, Remotion, React, Manim, Fish Audio, LangGraph, OpenAI, dan PostgreSQL.